前言
熟悉我的小伙伴都知道(如果你看到过我以前堆在博客上的一堆垃圾无营养学习笔记),我是从今年3月份左右开始正式学习编程的(我保证我以后再也不把所有笔记都抛在博客上了qwq)。而且你或许还可能知道这个站点(也就是你现在看见的这个 WordPress 站点)曾经被替换为一个我借助 AI 使用 Spring 手搓的博客框架一段时间。
那么为什么标题还是叫做“初体验”呢?这其实是因为当时我因为害怕自己无法驾驭进度太快的 Agent,所以其实整个项目都是在对话框里完成的。大致就是把 AI 给的示例代码读一遍然后拼贴起来最后组合成了一个勉强能跑的项目。——主要还是因为我认为一个尚未明白什么是控制反转和依赖注入的,只是刚学完了 OO 阶段的人能够驾驭的了一个开发节凑快速紧凑的 Agent 去完成一个项目——简而言之,就是害怕我在读不懂代码的情况下产出一堆答辩。再简而言之,我不会把这样的对话框编程称为“Vibe Coding”。
最近 DeepSeek Harness 出了 Desktop 版,正好下下来,突发奇想要试着 Vibe Coding 玩玩。
项目选型是一个 IDC 面板,主要内容就是映射上游的接口然后配合一堆 CRUD 把产品包装成自己的(至少售卖部分功能内容是这样的)。唔……应该算是个……中型项目吧?
总而言之,我以一名 Spring 初学者的身份开启了我的 VibeCoding 之旅。——这是一篇回答“零基础能不能 Vibe Coding”的问题的文章。
一开始写了几个增删改查的小模块的我自诩为“天才程序员”,但随着项目的推进,我越发感到自己在一坨项目代码面前的无力。我的 Coding 信息呈现出一条上升的直线,然后急剧下降。这篇文章,主要就来分享分享我遇到过的棘手问题。
本次 Vibe Coding 全程使用 DeepSeek-v4.1-flash-1017 模型。
同 AI Hallucination 斗争
AI 幻觉是个我 Vibe 中最先遇到的问题。
虽然 Harness 并没有全局提示词,但我还是在根目录维护了一份全局提示词,对项目分包逻辑、解构、测试流程等作了规定,然后每次对话都让 AI 读一下,可以起到与全局提示词一样的效果(大概吧?)
这是我在该 MD 提示词文件中对开发环境的部分说明:
## 技术栈(不得擅自变更)

- Java 17
- Spring Boot 4.1.1(Spring Framework 7,Jakarta EE 11)
- Spring Web / Spring Data JPA (Hibernate 7) / Spring Security 7
- MySQL 8.x,字符集 utf8mb4
- Lombok 1.18.34+(当前固定 1.18.34)
- Validation
- 构建:Maven

禁止引入未在 `pom.xml` 中声明的依赖。若确需新增,先在回答中单独列出并说明理由,等待确认。
可以看到,我明确说明了要求使用 Java 17 编写。可我还是在 IDE 中看到了 The Java feature 'Flexible Constructor Bodies' is only available with source level 25 and above 的警告。最后还是在提示词中再加入一句“禁止使用 Java 17 以上才支持的语法或 API(例如 Flexible Constructor Bodies);本项目编译目标固定为 Java 17。”才得以解决。
除此之外,还存在 import 一个包却 never used 及导入一些根本不存在的包等。都是加提示词解决。
过度防御的代码
AI 特别喜欢给我产出一堆极具防御性的代码。这里放一个判空,那里又是一个赋默认值,最后还来一套 try-catch,给我看的安全感十足十足的,直呼还是 AI 写的代码安全。
直到我突然发现映射上游接口的项目接口内得到的防火墙规则类型(存在 ACCEPT 与 DROP 两种值)与我自己从上游接口获得到的数据不一致。上游是 ACCEPT,可项目映射的接口获取到的防火墙规则类型却是 DROP。
经过一番翻阅,我发现了原因所在。访问上游接口返回的数据是:
FwMode: "white"
NetMode: "bridge"
NatPublicIP: "-"
NatList: []
MainIPv4: "110.*.*.*"
其中,规则返回的代码则是:
{"action":"ACCEPT","dest_port":"22","description":"SSH"}而问题就在于,AI 的前端代码里,居然是使用 accept(小写字母)进行规则类型的匹配的。后端接口返回的是“ACCEPT”,自然是匹配不上的。
{{ rule.action === 'accept' ? '允许' : '拒绝' }}
先不论明明应当是先测试接口再写的代码怎么会出现最基本的值的匹配都出这样的低级错误,或者我们就先假设这是 AI 幻觉导致的,但是重要的不在这里。
重要的是,这个 AI 为什么要把未知值赋上一个默认值?防火墙规则类型总共就两种基本的确定的值,遇到匹配不上值的情况,难道不应该直接报错,好让我知道这里有问题吗?
自己悄悄附上一个随便的值不是掩耳盗铃吗?——把问题靠默认赋值掩盖住,就能避免问题发生了?究竟是什么样的思考逻辑才能写出这样的代码来?
这样的代码,难道不是过度的、无用的,甚至适得其反的防御性代码吗?——代码看似安全到爆炸,但这样一个配置不存在,不就应该直接报错吗?
PUA 了一番 AI,叫它别再拿二元表达式给未知值兜底了,然后继续深究 AI 在后端给防火墙 action 部分写的新代码:
private String normalizeFirewallAction(String action) {
    String normalized = action == null
            ? ""
            : action.trim().toLowerCase(Locale.ROOT);

    if ("accept".equals(normalized) || "drop".equals(normalized)) {
        return normalized;
    }

    throw new RainyunException(0, "上游返回未知防火墙动作:" + action, false);
}
可以看出来,AI 对从上游拿到的数据极不放心。拿着三元表达式它先是判了一个空,然后还转写了一遍小写,最后还要删一下可能存在的空格。
稳的很呐。但问题在于,为什么要认为上游接口返回数据是不可信的呢?上游不可能返回 "Accept",更不可能返回 " ACCEPT ",这样一个数据规范化的操作,完全是没必要的吧?(我后续试试能不能靠提示词解决)
除此之外,还经常出现本来应该交给 Global Exception Handler 统一处理的报错先被 AI 自己 catch 掉了的情况。那前面写的全局异常处理又有什么意思呢?
我觉得这些问题应该都可以归结于 AI 大模型的上下文不足,所以 AI 其实对整个项目都缺乏认知。说不定它可能写某个代码的时候都完全不知道这个项目有个全局异常处理呢。
画蛇添足的贴心
我也让 AI 写了一个 SMTP 发信模块。
AI 十分“贴心”地为我写了一个发送频率限制的代码。——但问题在于,我不知道它写了这些代码。
例如,这是 AI 写的注册邮箱验证码的 Controller 的部分代码:
    /** 发送注册邮箱验证码 */
    @PostMapping("/email-code")
    public R sendEmailCode(
            @Valid @RequestBody SendEmailCodeRequest request,
            HttpServletRequest httpRequest) {
        return R.ok(emailVerificationService.sendRegisterCode(request.getEmail(), httpRequest.getRemoteAddr()));
    }

    /** 发送找回密码邮箱验证码 */
    @PostMapping("/password-reset/code")
    public R sendPasswordResetCode(
            @Valid @RequestBody SendEmailCodeRequest request,
            HttpServletRequest httpRequest) {
        return R.ok(emailVerificationService.sendPasswordResetCode(
                request.getEmail(), httpRequest.getRemoteAddr()));
    }
可以看到,所有取 IP 的地方,都是直接调用的 getRemoteAddr()。也就是说,被交给 Service 进行频控的 IP 直接取自网络连接。
可 99% 的业务环境,源站前都是要套至少一层的代理的吧?要是这是我主动要求的,倒也没什么,毕竟我要求其考虑使用请求头获取 IP 地址就是了。但假使我没有阅读 AI 产出的代码,直接将其上线,到最后不就成了全站人共用一个频率统计桶了?到时候又要排查一遍代码。
这样的隐患,本是没有必要出现的,对吗?
但是由于人类不可能在提示词中完完整整写出自己的部署环境细节(也就是说,人类的提示词都是极不完备的,往往只有一个大致的实现方向),而因为提示词的不完备性,AI 就必然地要自己脑补一些逻辑来,而又恰恰因为其不完备性,所以 AI 脑补出来的东西有时就会与现实或预想效果出现偏差。所以,就是说,Vibe Coding 下代码与实际业务环境的脱节是不可避免地要发生的。
后记
还有其他杂七杂八的,例如理解错业务逻辑,或是“想当然地”不考虑情况地将某个业务缝合到另一个本相互排斥的业务上。而又正如前文所言,AI 的注意力都放在了代码的局部安全与正确上,丝毫无法意识到一个独立公网型机器是不可能被人操作什么 NAT 映射规则的(这不纯搞笑吗?)。而代码的大部分问题要么是被默认赋值了,要么就是被 AI 自己偷偷 catch 掉了,所以这样的问题代码就在通过了一轮轮“全量测试”后被 AI 以一副“代码绝对没问题”的姿态交付给我。
这种显眼的问题还好说,我都不用自己测试就能发现问题,但如果是更加潜在的问题呢?恐怕就只能作为一个 bug 潜伏在项目代码里了吧?
总之,目前人在编程中作为主体的重要性,并没有因 AI 这一工具而消失。项目经验与编程素养貌似在 AI 时代反而变得比以前更加重要了。
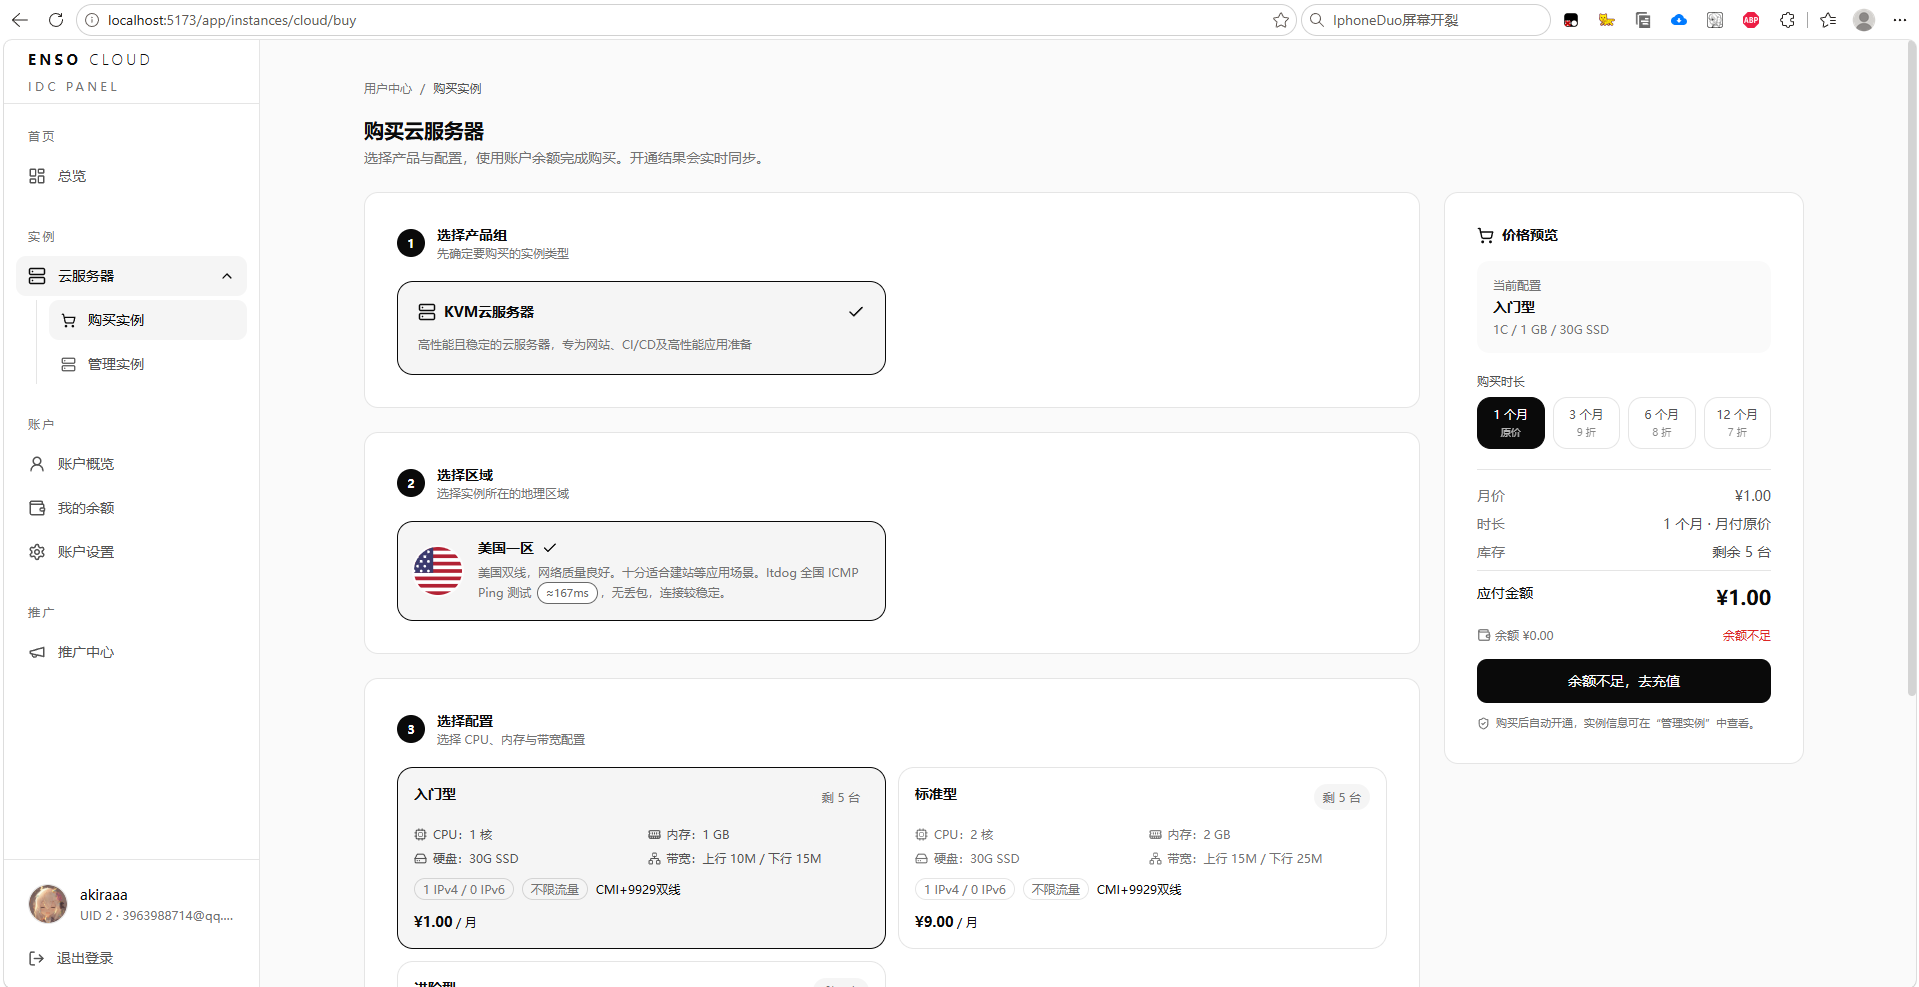
我会尝试在未来不断精进自己的编程技术的。不过如果我能把这个 IDC 项目改的不那么屎山,说不定过个两年,我会将其在我高考后悄悄上线运营的www。
最后附图一张:
Comments NOTHING